Slurm
Slrum作业
介绍
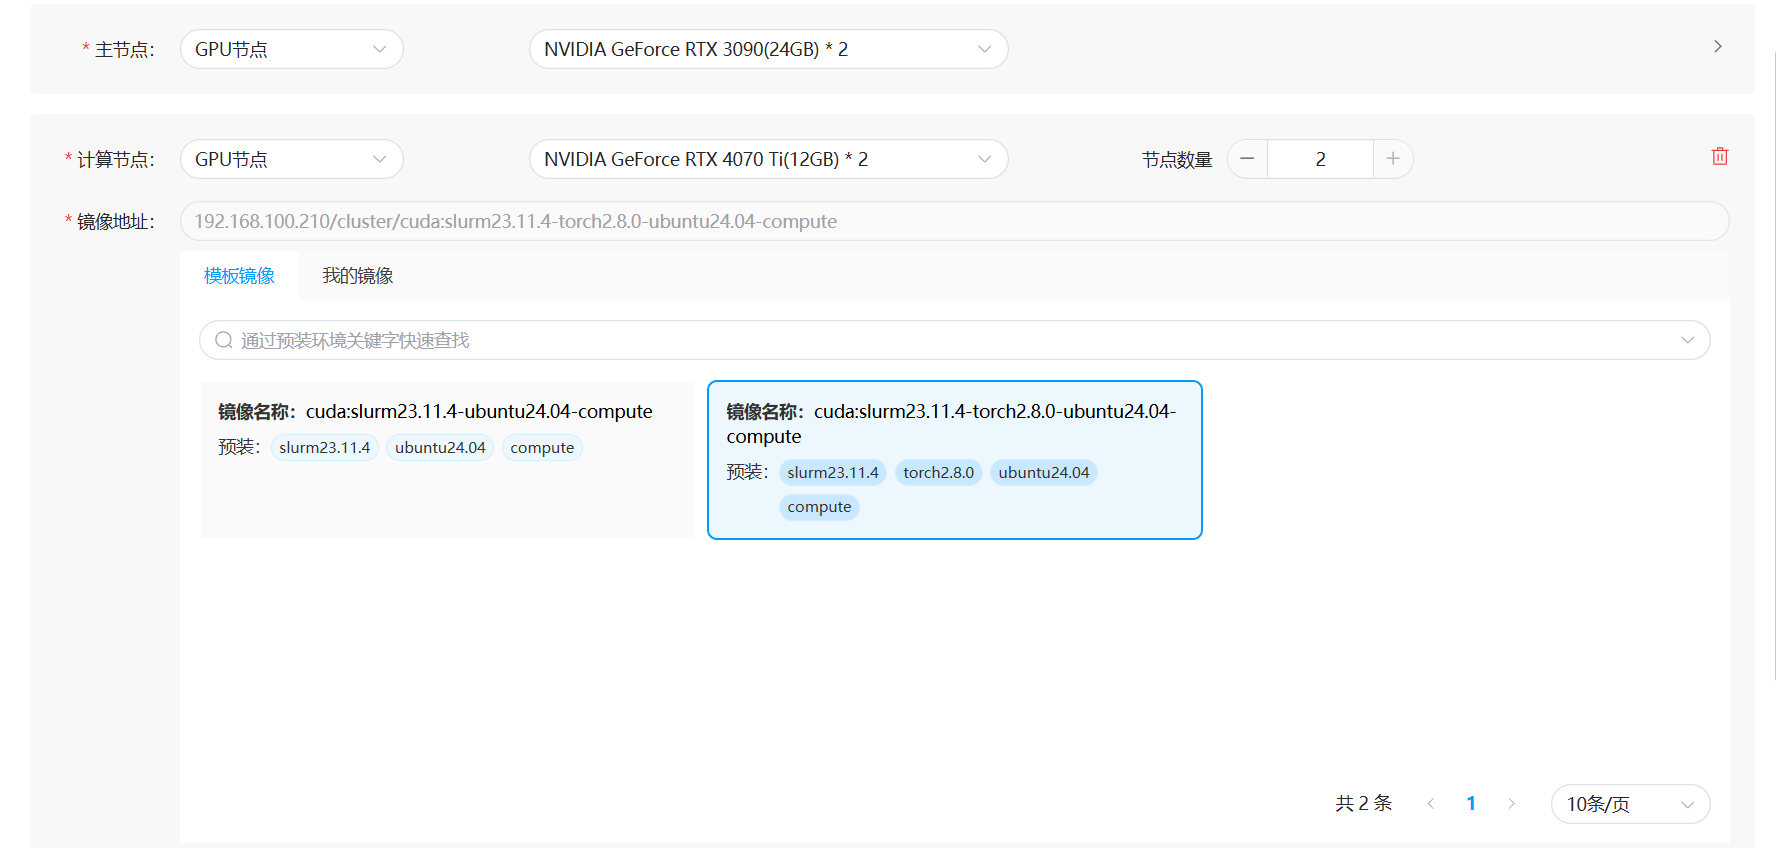
炎扉算力调度平台内部集成了slurm,以容器的方式运行。用户可以在集群中新增多个slurm作业系统,且每个slurm作业系统都可以独立地运行。为了减轻slurm相关的配置,用户只需要选择主节点、计算节点,就可以进行slurm作业的提交。如图:
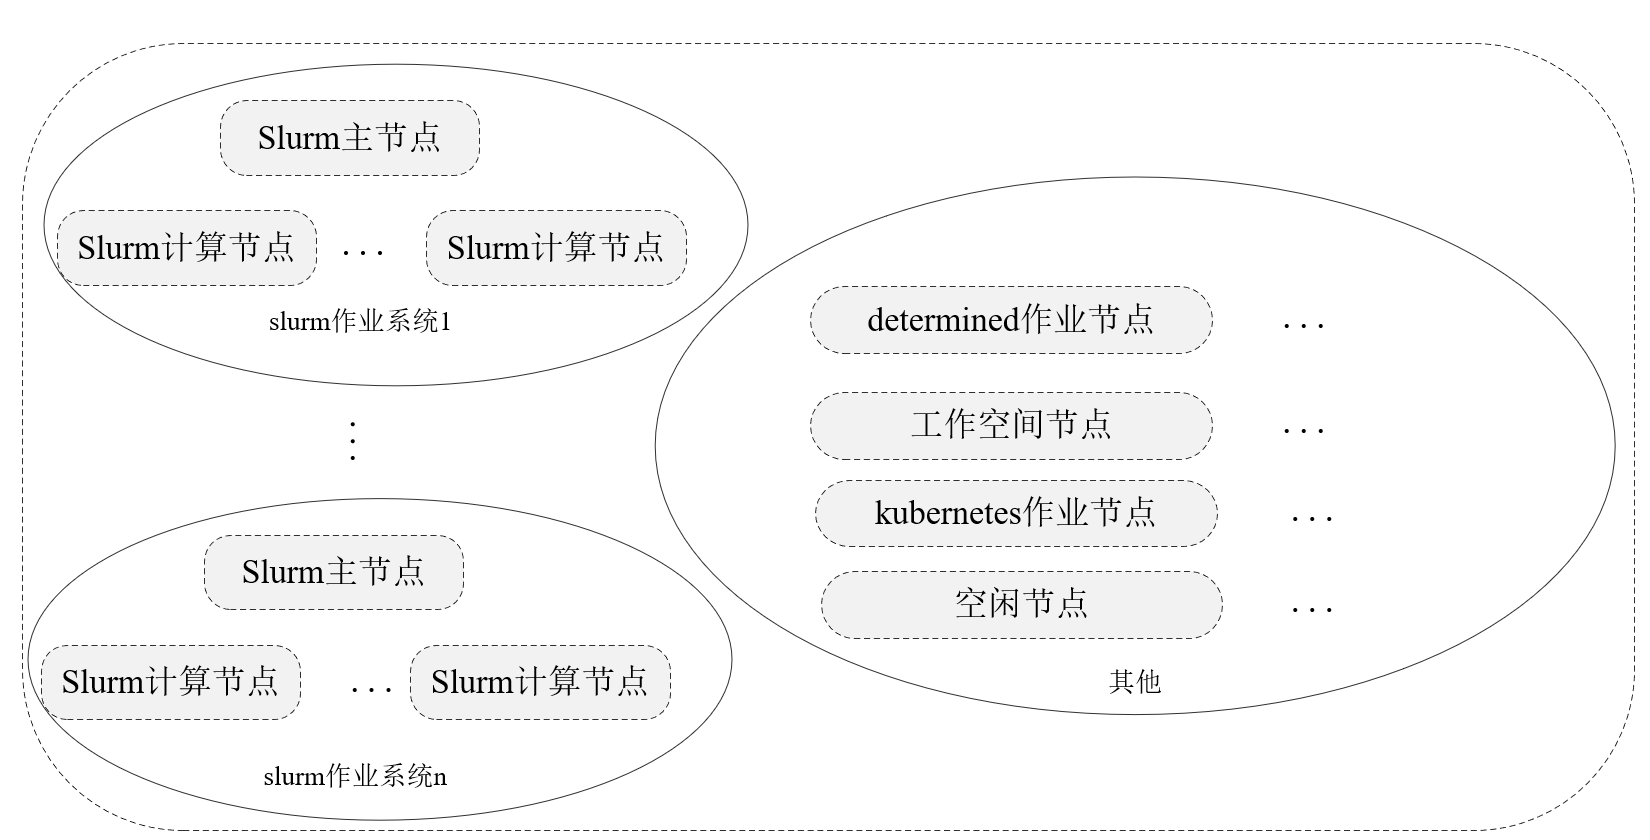
炎扉算力调度平台的slurm作业系统以整台机器为调度,即最少调度一台机器(作为主节点),同时主节点也可以进行科学计算。主节点运行了数据库服务(slurmdbd以及mysql)、slurmctld服务和slurmd服务。计算节点上仅运行slurmd服务。
特点
-
设备兼容新高:同一个slurm作业系统内部,可以管理不同配置的机器(支持异构,slurm原生支持),包括显卡,内存,cpu等;
-
操作简单:无需准备slurm原始的相关配置,slurm作业系统内部自动完成节点间的相关配置;
-
作业可视化:提供web端作业可视化报表,支持web端取消作业;
-
系统级隔离:支持启动多个slurm作业系统(相当于每个集群里独立的部署slurm),不同的slurm作业系统相互隔离,不受影响。
slurm简介
1.说明
Slurm(Simple Linux Utility for Resource Management )是开源的、具有容错性和高度可扩展的Linux集群超级计算系统资源管理和作业调度系统。超级计算系统可利用Slurm对资源和作业进行管理,以避免相互干扰,提高运行效率。所有需运行的作业,无论是用于程序调试还是业务计算,都可以通过交互式并行 srun 、批处理式 sbatch 或分配式 salloc 等命令提交,提交后可以利用相关命令查询作业状态等。更多内容可以参考文档
2.架构
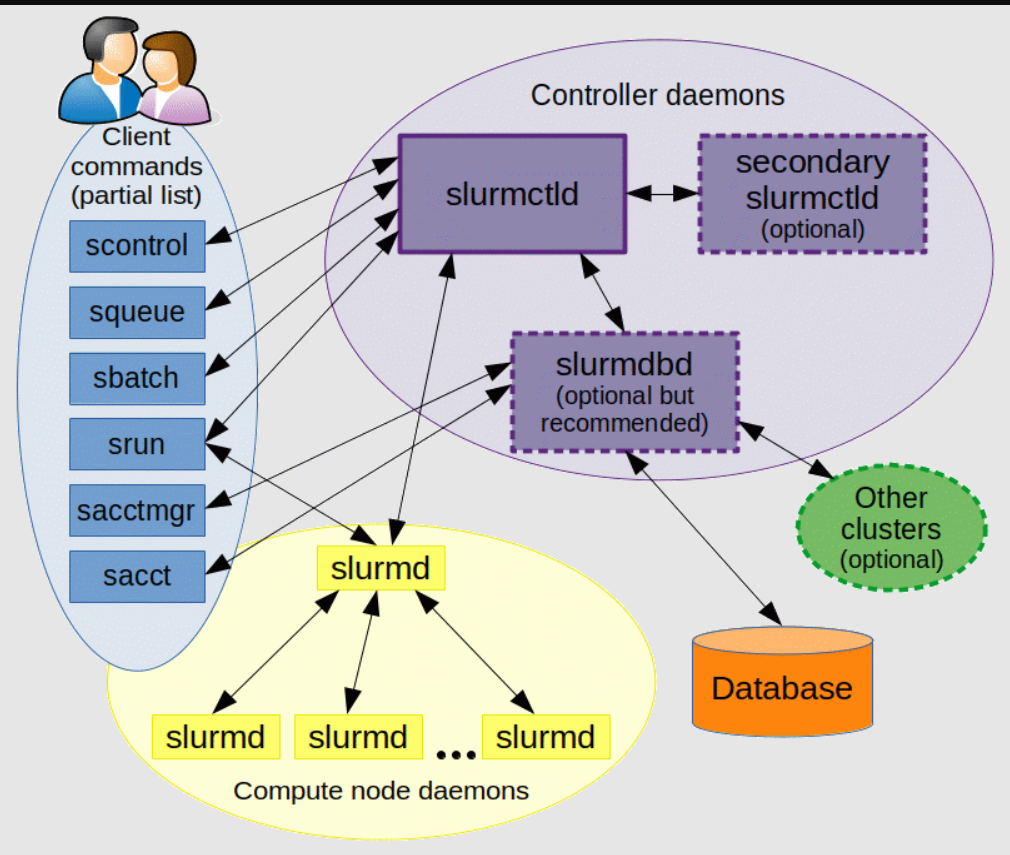
Slurm采用slurmctld服务(守护进程)作为中心管理器用于监测资源和作业,为了提高可用性,还可以配置另一个备份冗余管理器。各计算节点需启动slurmd守护进程,以便被用于作为远程shell使用:等待作业、执行作业、返回状态、再等待更多作业。slurmdbd(Slurm DataBase Daemon)数据库守护进程(非必需,建议采用,也可以记录到纯文本中等),可以将多个slurm管理的集群的记账信息记录在同一个数据库中。还可以启用slurmrestd(Slurm REST API Daemon)服务(非必需),该服务可以通过REST API与Slurm进行交互,所有功能都对应的API。用户工具包含 srun 运行作业、 scancel 终止排队中或运行中的作业、 sinfo 查看系统状态、 squeue 查看作业状态、 sacct 查看运行中或结束了的作业及作业步信息等命令。 sview 命令可以图形化显示系统和作业状态(可含有网络拓扑)。 scontrol 作为管理工具,可以监控、修改集群的配置和状态信息等。用于管理数据库的命令是 sacctmgr ,可认证集群、有效用户、有效记账账户等。
3.术语
-
节点
-
Head Node:头节点、主节点、管理节点、控制节点,运行slurmctld管理服务的节点。
-
Compute Node:计算节点,运行作业计算任务的节点,需运行slurmd服务。
-
Login Node:用户登录节点,用于用户登录的节点。
-
SlurmDBD Node:SlurmDBD节点、SlurmDBD数据库节点,存储调度策略、记账和作业等信息的节点,需运行slurmdbd服务。
-
客户节点:含计算节点和用户登录节点。
-
-
用户
-
account:账户,一个账户可以含有多个用户。
-
user:用户,多个用户可以共享一个账户。
-
bank account:银行账户,对应机时费等。
-
-
资源
-
GRES:Generic Resource,通用资源。
-
TRES:Trackable RESources,可追踪资源。
-
QOS:Quality of Service,服务质量,作业优先级。
-
association:关联。可利用其实现,如用户的关联不在数据库中,这将阻止用户运行作业。该选项可以阻止用户访问无效账户。
-
Partition:队列、分区。用于对计算节点、作业并行规模、作业时长、用户等进行分组管理,以合理分配资源。
-
4.插件
Slurm含有一些通用目的插件可以使用,采用这些插件可以方便地支持多种基础结构,允许利用构建块方式吸纳多种Slurm配置,主要包括如下插件:
记账存储(Accounting Storage):主要用于存储作业历史数据。当采用SlurmDBD时,可以支持有限的基于系统的历史系统状态。
账户收集能源(Account Gather Energy):收集系统中每个作业或节点的能源(电力)消耗,该插件与记账存储Accounting Storage和作业记账收集Job Account Gather插件一起使用。
通信认证(Authentication of communications):提供在Slurm不同组件之间进行认证机制。
容器(Containers):HPC作业负载容器支持及实现。
信用(Credential,数字签名生成,Digital Signature Generation):用于生成电子签名的机制,可用于验证作业步在某节点上具有执行权限。与用于身份验证的插件不同,因为作业步请求从用户的
srun命令发送,而不是直接从slurmctld守护进程发送,该守护进程将生成作业步凭据及其数字签名。通用资源(Generic Resources):提供用于控制通用资源(如GPU)的接口。
作业提交(Job Submit):该插件提供特殊控制,以允许站点覆盖作业在提交和更新时提出的需求。
作业记账收集(Job Accounting Gather):收集作业步资源使用数据。
作业完成记录(Job Completion Logging):记录作业完成数据,一般是记账存储插件的子数据集。
启动器(Launchers):控制srun启动任务时的机制。
MPI:针对多种MPI实现提供不同钩子,可用于设置MPI环境变量等。
抢占(Preempt):决定哪些作业可以抢占其它作业以及所采用的抢占机制。
优先级(Priority):在作业提交时赋予作业优先级,且在运行中生效(如,它们生命期)。
进程追踪(Process tracking,为了信号控制):提供用于确认各作业关联的进程,可用于作业记账及信号控制。
调度器(Scheduler):用于决定Slurm何时及如何调度作业的插件。
节点选择(Node selection):用于决定作业分配的资源插件。
站点因子(Site Factor,站点优先级):将作业多因子组件中的特殊的site_factor优先级在作业提交时赋予作业,且在运行中生效(如,它们生命期)。
交换及互联(Switch or interconnect):用于网络交换和互联接口的插件。对于多数网络系统(以太网或InifiniBand)并不需要。
作业亲和性(Task Affinity):提供一种用于将作业和其独立的任务绑定到特定处理器的机制。
网络拓扑(Network Topology):基于网络拓扑提供资源选择优化,用于作业分配和提前预留资源。
5.配置
Slurm客户节点配置,有两种模式:
传统模式:客户节点采用 /etc/slurm/ 目录下的 slurm.conf 等配置文件进行配置。
无配置(configless)模式:客户节点无需配置 /etc/slurm 目录下相应的配置文件。
无配置模式是Slurm的一项新特性(从20.02版起支持),可以允许计算节点和用户登录节点从slurmctld守护进程获取配置而无需采用 /etc/slurm 等目录下的本地配置文件。集群在Slurm控制节点上统一控制配置文件,计算节点、登录节点和其它集群节点只需通过 /lib/systemd/system/slurmd.service 文件配置slurmd服务启动参数,利用启动后的slurmd服务获取所需配置信息即可,而无需复制管理节点上的这些文件成为本地文件(降低文件配置不一样的风险)。支持的配置文件有:
slurm.conf
slurmdbd.conf
acct_gather.conf
cgroup.conf
cgroup_allowed_devices_file.conf
cli_filter.lua
ext_sensors.conf
gres.conf
helpers.conf
job_container.conf
knl_cray.conf
knl_generic.conf
oci.conf
plugstack.conf
topology.conf
slurmd服务启动时将从指定的slurmctld节点获取配置文件,slurmctld节点可以采用 --conf-server 参数准确指定或利用DNS SRV记录指定,采用 --conf-server 参数指定的优先级高于采用DNS SRV记录指定:
采用
--conf-server参数指定(默认端口6817可省略):
仅一个管理节点slurmctl-primary:
slurmd --conf-server slurmctl-primary:6817一个管理节点slurmctl-primary和一个备份节点slurmctl-secondary:
slurmd --conf-server slurmctl-primary:6817,slurmctl-secondary采用DNS SRV记录:
_slurmctld._tcp 3600 IN SRV 10 0 6817 slurmctl-backup
_slurmctld._tcp 3600 IN SRV 0 0 6817 slurmctl-primary
创建步骤
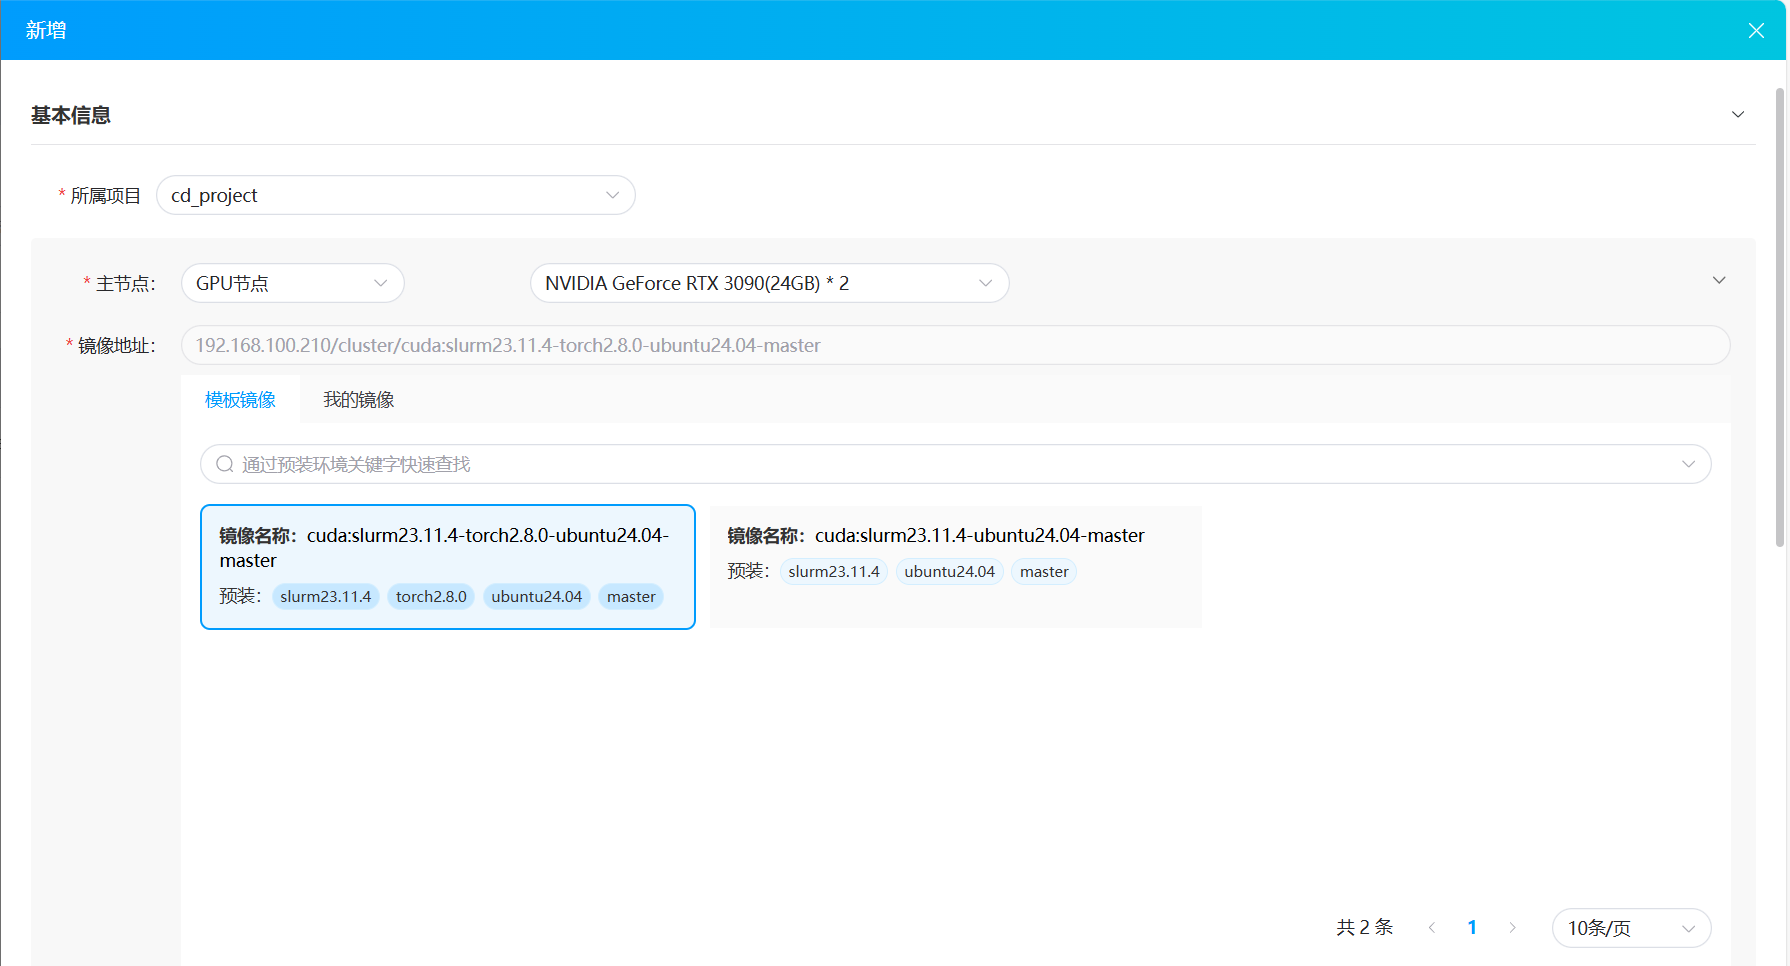
创建slurm作业系统很简单,在集群软件的作业管理的slurm中单击新增,然后选择主节点(必须)和计算节点(根据需求添加,可不添加),选择合适的镜像。下面是一个简单示例,可以参照。
示例
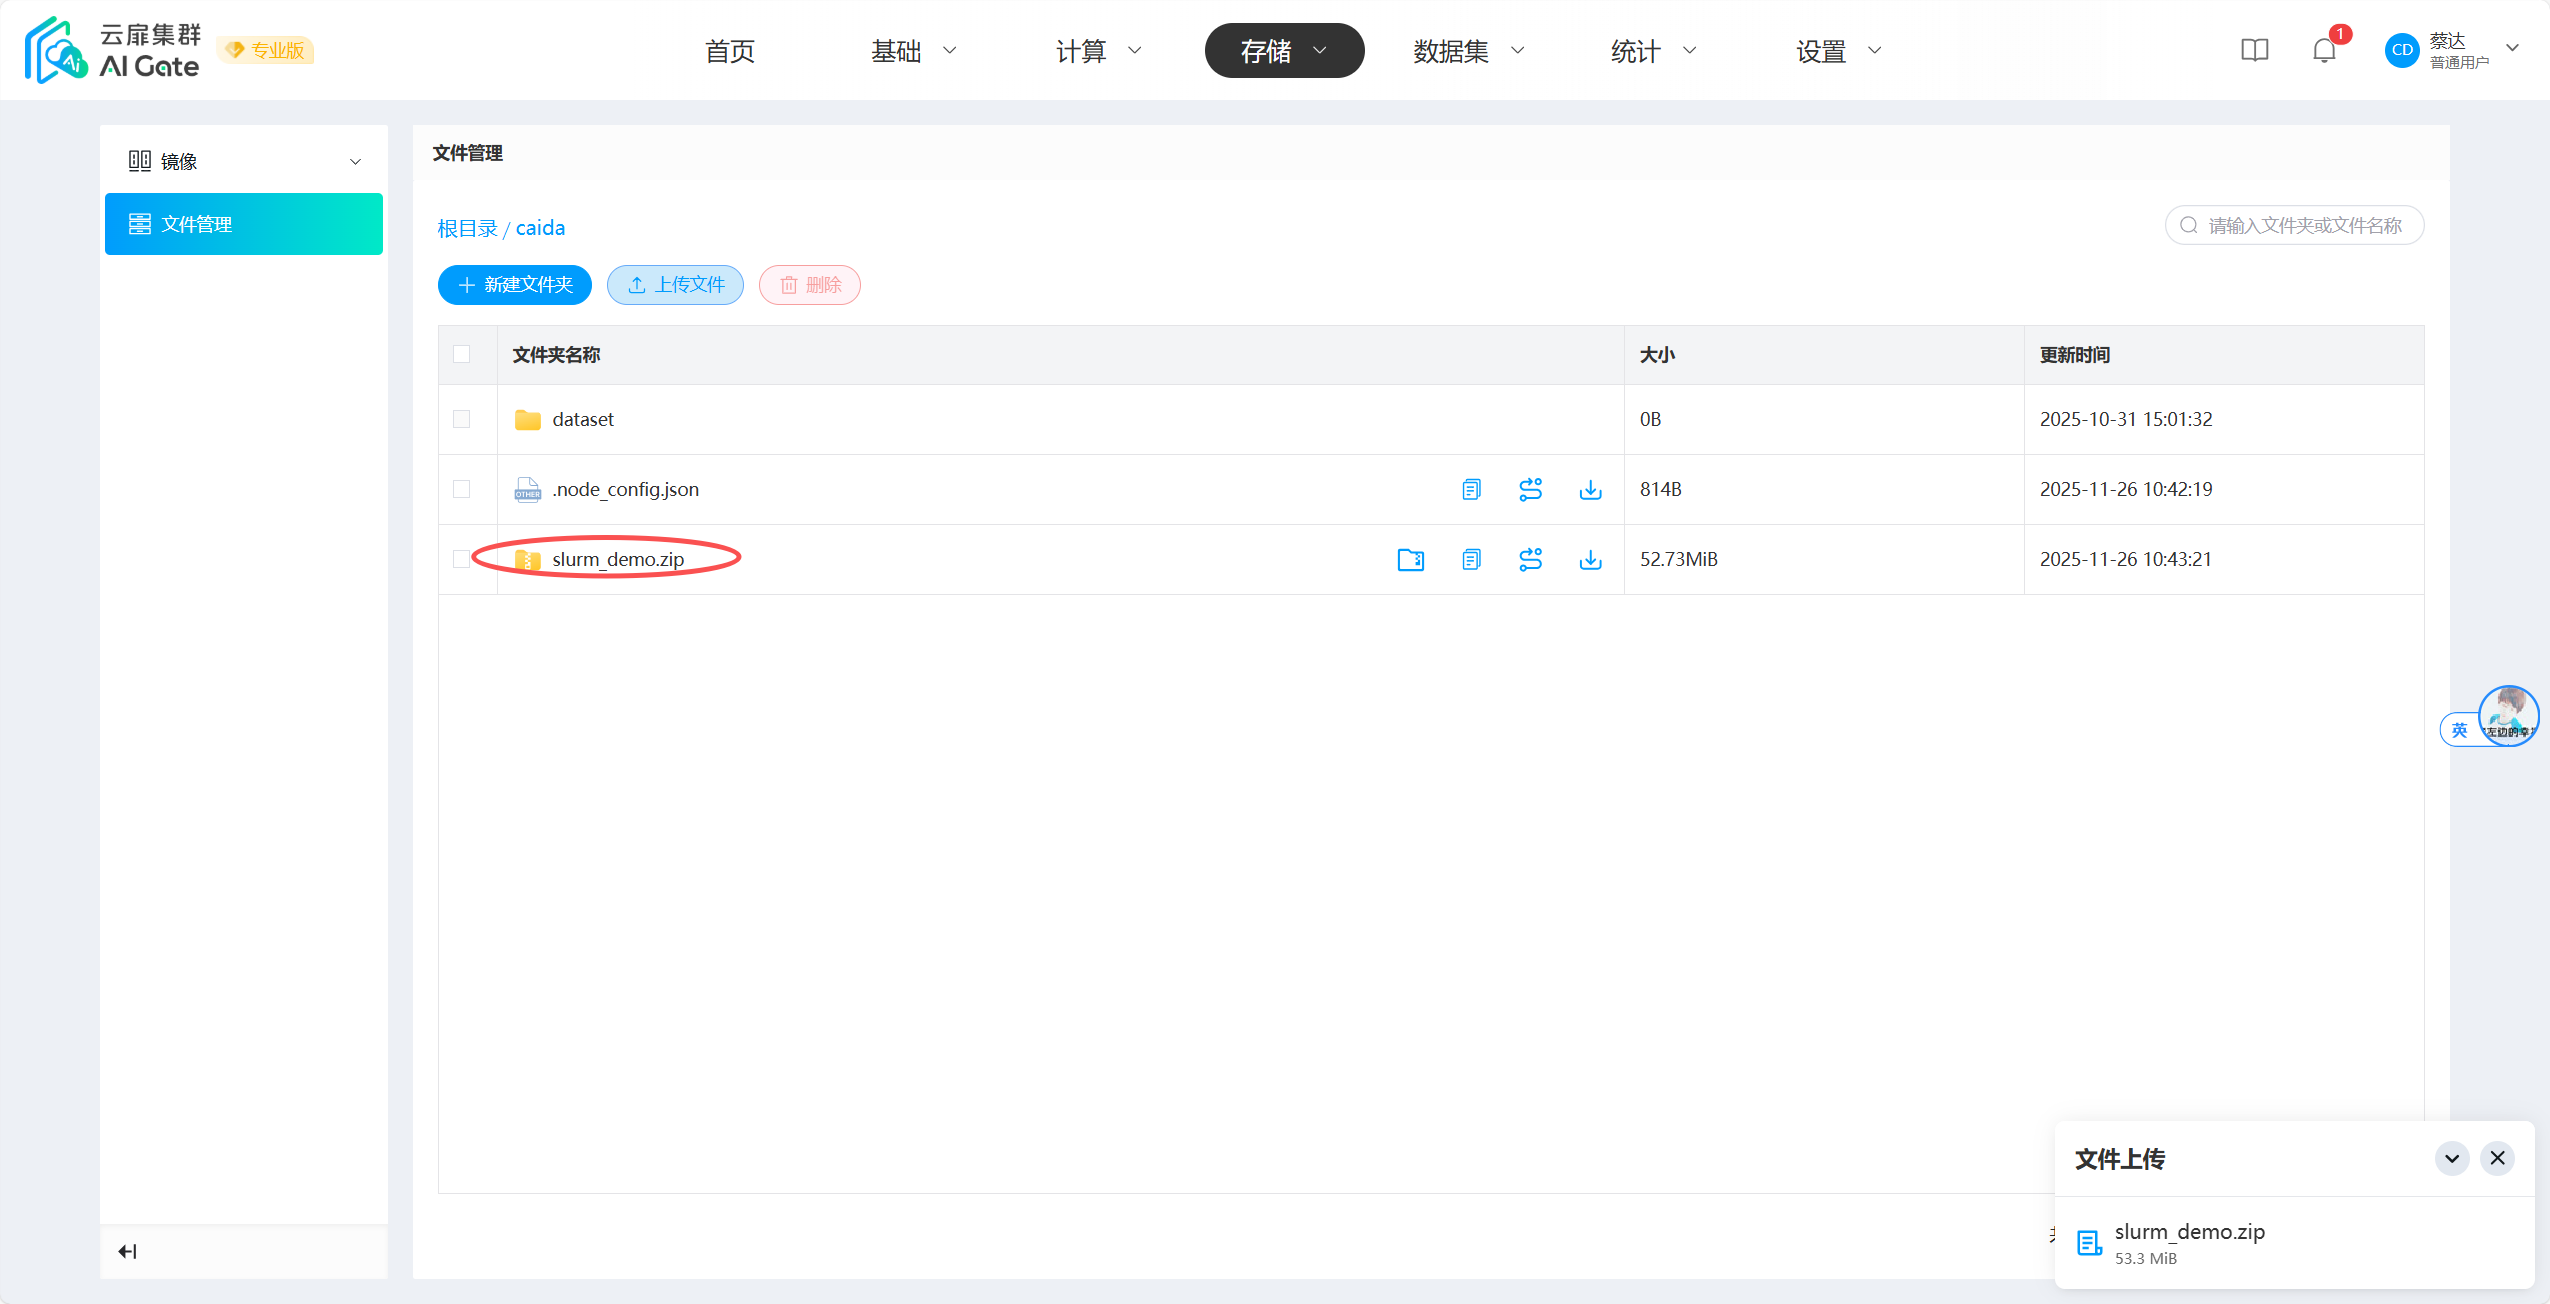
我们提供了可运行代码,这里下载,下载完成后上传至用户目录。
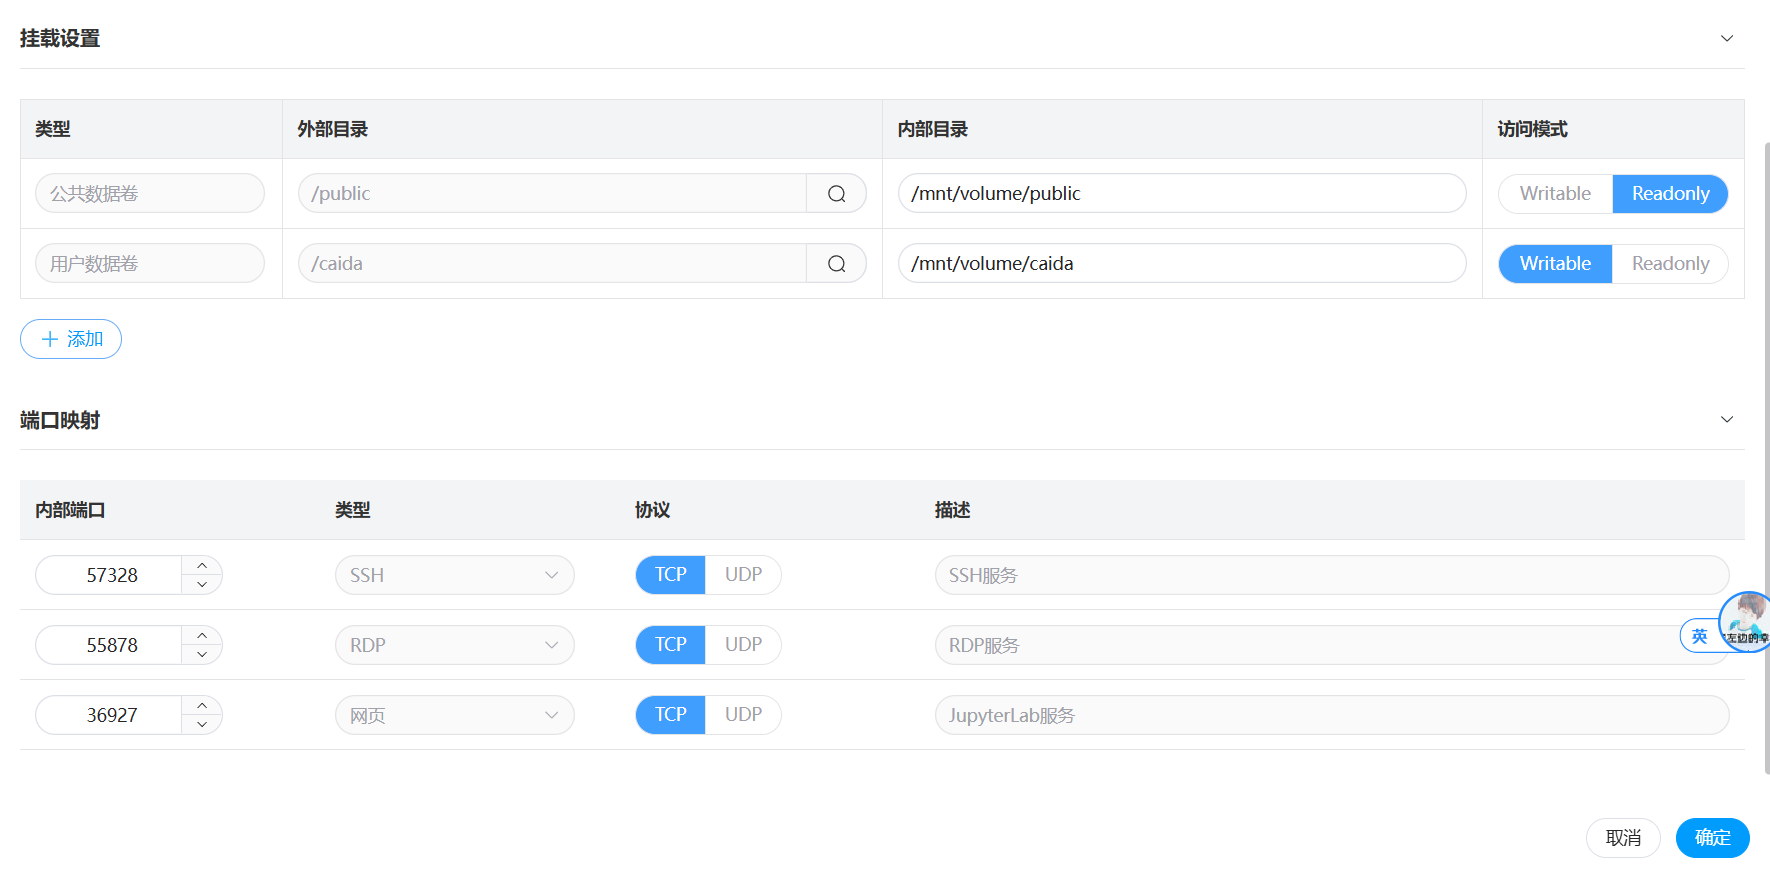
点击新增slurm作业,并选择主节点,计算节点。注意,主节点和计算节点镜像不一样,主节点带有master,计算节点带有compute字样。
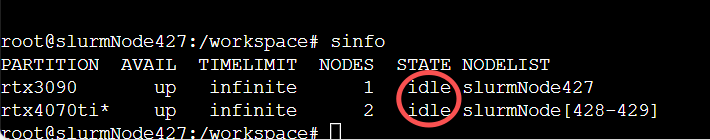
等待节点启动完成后,进入Console,输入sinfo,查看节点是否全部idle。
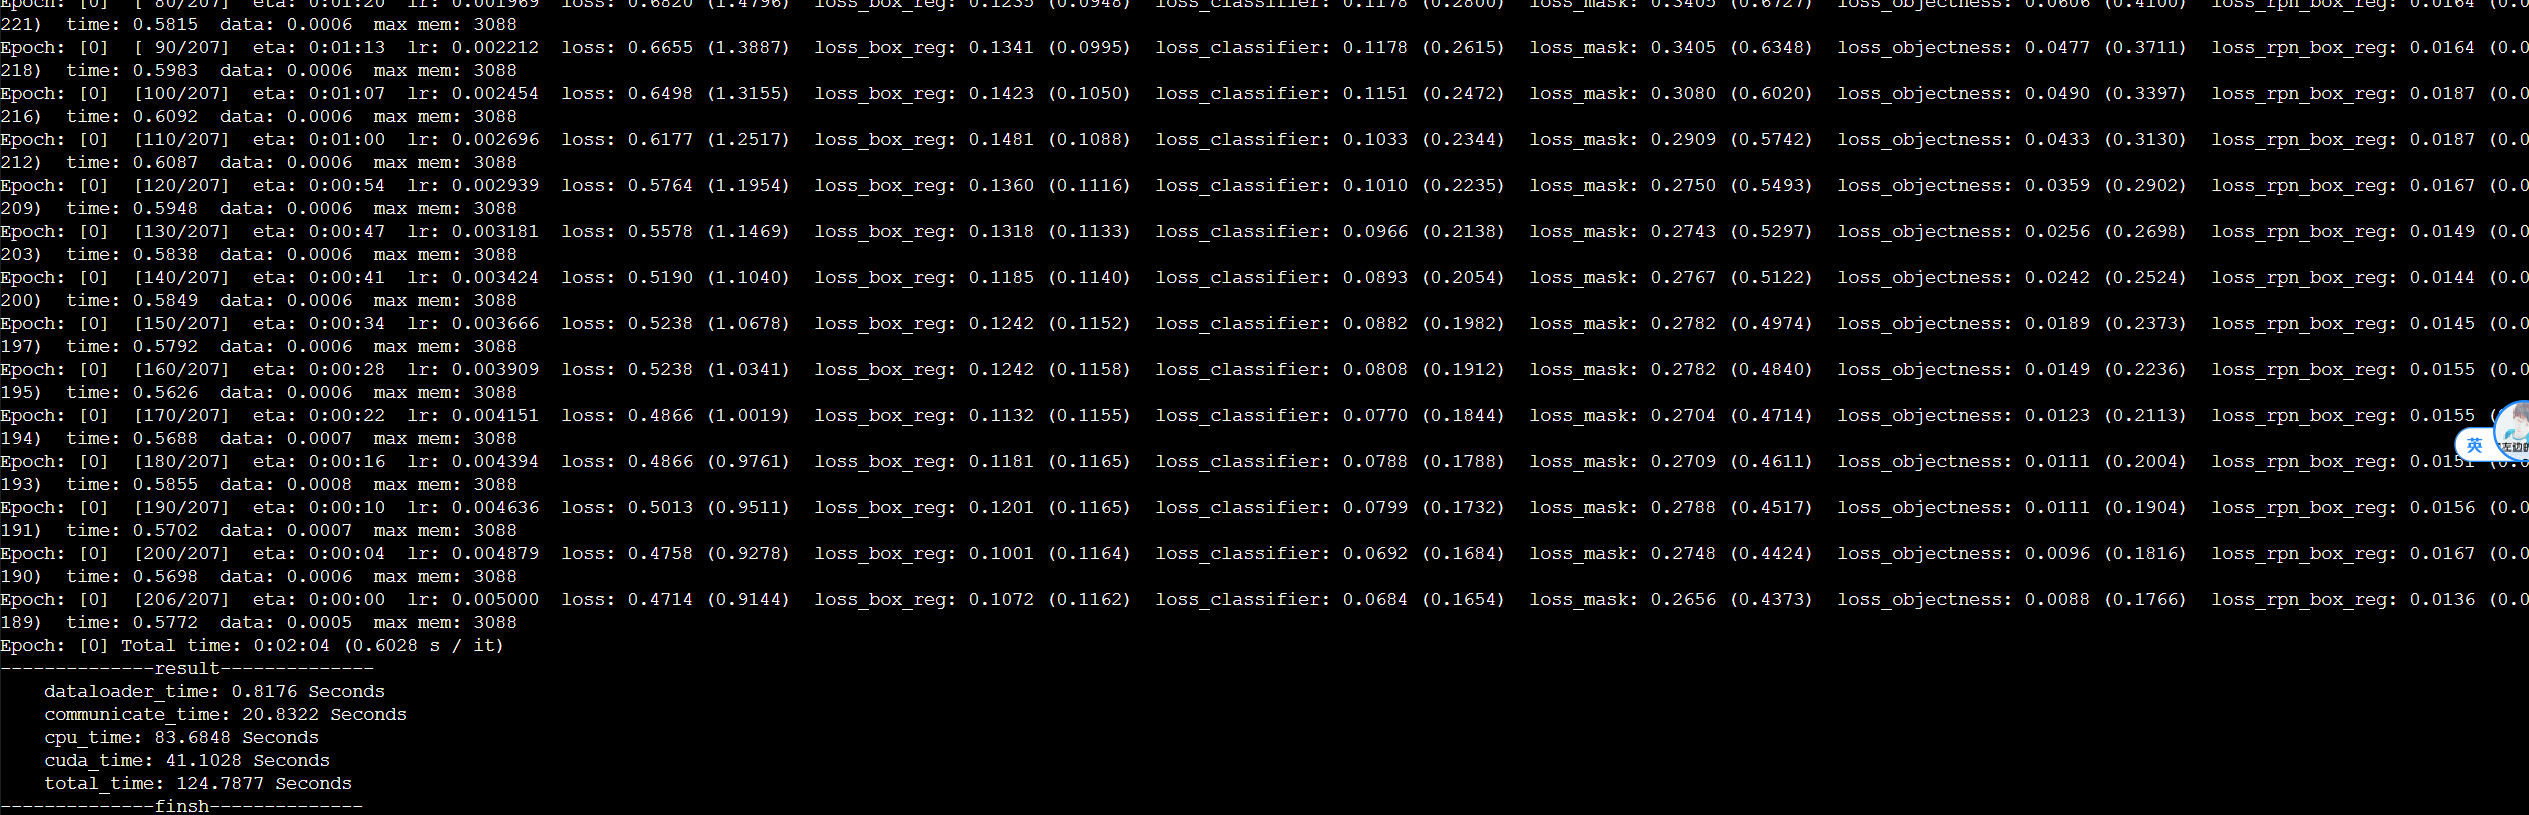
解压代码文件,并执行多机训练。
cd /mnt/volume/{你的用户目录}   # 这里是 cd /mnt/volume/caida
unzip slurm_demo.zip
cd slurm_demo

# 安装相关依赖
sbatch -N2 --partition=rtx4070ti --wrap "pip install -r requirements.txt"

#训练:指定2台节点,每台两张卡
srun --partition=rtx4070ti -N2 -n4 --gres=gpu:2 --ntasks-per-node=2 --job-name=slrum_test python3 -u train.py
注意,这里的节点数量,分区名称,每个节点的进程数量,gpu数量,请根据实际环境的数量决定,这里只是演示了一个2节点,分区名为rtx4070ti,每个节点两张卡的训练。
更多信息
-
炎扉算力调度平台slurm作业系统,对slurm进行了封装,提供了web端的可视化作业报表。用户可以查看作业的状态,并且取消作业;
-
slurm作业系统默认连接方式有三种,ssh,rdp,jupyterlab。它们提供的是主节点ip,计算节点的ip可以进入主节点进行查询,密码和主节点相同;
-
为了避免多机任务中每个节点的数据都要进行复制,请使用集群的分布式存储。slurm作业系统内部的每个节点都默认挂载了用户目录
/mnt/volume/{用户名}和公共目录/mnt/volume/public。 -
slurm容器使用的是
host模式,无需进行端口映射,直接使用ip+端口的就可以访问自定义的服务; -
如果修改导致的slurm无法使用,可以在页面重新创建slurm作业。slurm相关的配置文件在文件夹
/etc/slurm/下; -
若存在显卡,默认为节点设置的分区(
PARTITION)为显卡名,同种型号的显卡会合并。如果是CPU节点,分区名就是CPU型号,同型号的cpu会合并。如果分区设置不满足实际使用中的需求,请修改slurm的配置文件; -
为了使得容器可以像宿主机一样,进行资源分配/进程管理,运行的容器设置了privileged权限,安装了systemd,以及挂载了宿主机的cgroup。使用时请不要进行危险操作。
Docker in Docker
炎扉算力调度平台运行的slurm容器,配置了privileged权限以及systemd,可以在容器内部安装docker(不推荐),容器里的 Docker 是独立 DinD(Docker-in-Docker),不会直接影响宿主机服务。安装步骤如下:
# 使用root 用户执行
apt-get update
apt-get install -y ca-certificates curl gnupg lsb-release
mkdir -p /etc/apt/keyrings
curl -fsSL https://download.docker.com/linux/ubuntu/gpg | sudo gpg --dearmor -o /etc/apt/keyrings/docker.gpg
echo \
  "deb [arch=$(dpkg --print-architecture) signed-by=/etc/apt/keyrings/docker.gpg] \
  https://download.docker.com/linux/ubuntu \
  $(lsb_release -cs) stable" | \
  tee /etc/apt/sources.list.d/docker.list > /dev/null
apt-get update
apt-get install -y docker-ce docker-ce-cli containerd.io
systemctl start docker
除非必要,否则不推荐在容器中安装docker,可能存在的问题如下:
- 文件系统操作稍微复杂时,性能会比直接在宿主机慢;
- 某些情况下可能出现 “device or resource busy” 错误;
- 容器挂载了
--cgroupns=host,如果在 DinD 容器里启动大量容器,宿主机资源也会被消耗; - DinD 容器里的 Docker 网络(bridge、overlay)可能会有一些端口冲突或延迟。
常用操作命令
systemctl restart slurmctld     # 重启slurmctld
systemctl restart slurmd    # 重启slurmd
sinfo    # 查看所有节点状态信息
scontrol show node ${NodeName}    # 查看某个节点的具体信息
scontrol update NodeName=${NodeName} State=RESUME    # 尝试修复某个节点
scontrol reconfig    # 刷新配置文件,使其生效
squeue    # 查看运行中的作业
scancel ${job_id}    # 取消作业
sacct    # 查看全部作业
sbatch run.sh    # 提交作业
注意事项
- 炎扉算力调度平台的slurm相关配置是在容器中的,由于给了较高的权限(privileged),slurm像部署在主机上一样,可以进行cpu核等资源的分配,系统资源的管理。与此同时,privileged也打破了安全隔离,容器中的进程可以直接操作宿主机设备、加载内核模块、甚至修改宿主机文件系统(如
/etc、/var/lib/docker等)。除非你知道在做什么,否则请不要进行类似的危险操作。 - 炎扉算力调度平台默认为slurm配置了可运行的配置文件(
/etc/slurm/slurm.conf),修改可能会导致slurm功能无法使用。如果你slurm的配置比较熟悉,可自行修改,并重启相关服务。 - slurm运行时的容器使用的是
host模式,即使用了宿主机的端口,请注意是否存在端口冲突,否则相关服务可能无法启动。 - slurm作业系统提供了三种连接方式(ssh,rdp,jupyterlab),请不要随意更改相关配置文件。否则,可能会导致无法连接。